虚拟人视频背后的5层技术栈全拆解
发布时间:2026/6/14 9:29:42虚拟人视频制作本质上是一条五层技术链路:建模→驱动→语音→渲染→合成,每层都有成熟工具可选。
第一层:形象建模。 传统路线用Maya、Blender、ZBrush手动建模,周期长、成本高。现在主流走两条捷径:一是MetaHuman Creator等工具从预设库选模板改脸,10分钟出形象;二是用手机拍10秒视频做摄影测量重建,Reality Capture或Metashape自动生成3D模型,精度可达亚毫米级。
第二层:动作驱动。 分两派——真人驱动靠动捕设备(VDMocap、Xsens)采集骨骼和表情数据,精度高但设备贵;AI驱动靠深度学习模型自动匹配口型、表情和肢体动作,小冰的XNR神经渲染技术是代表,全自动实时输出,适合直播和批量生产。
第三层:语音合成。 TTS引擎把文本转语音,再用NLP做语义解析。2026年唇形同步精度已达95%以上,配合AI声音克隆,肉眼几乎分辨不出真假。
第四层:渲染输出。 离线渲染用Arnold、V-Ray,效果顶但慢;实时渲染靠UE5+光追,魔珐有言、即梦AI、可灵AI等平台已把这步做到一键导出1080P。
第五层:后期合成。 剪映、PR做剪辑包装,AI自动识别字幕,绿幕抠图合成背景,多平台适配画幅一键导出。
多个形态 多种资产 个性定义
智能推荐
商务接待
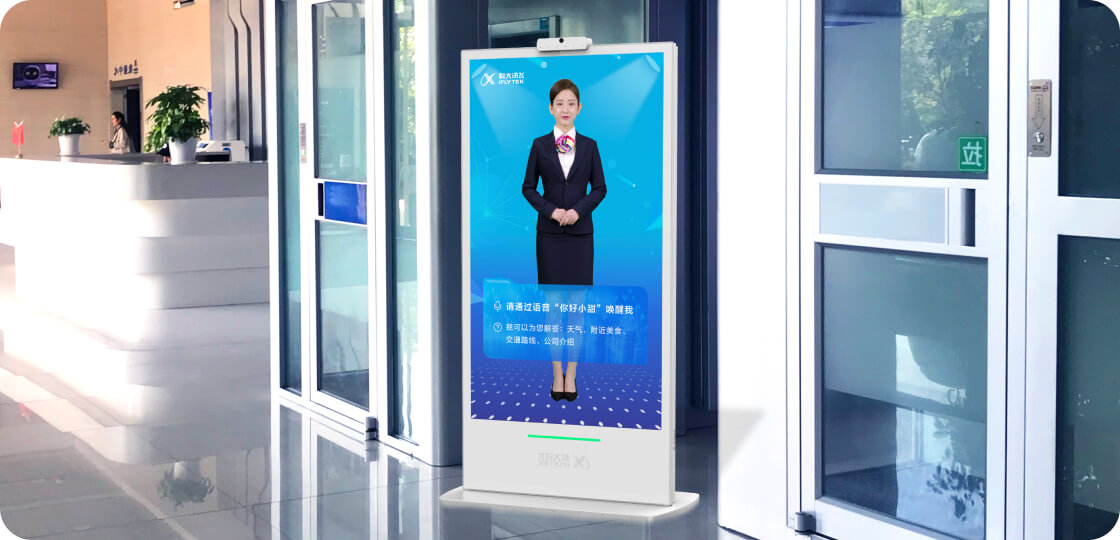
虚拟人借自然语言交互,生动讲解大屏数据与业务逻辑,提升访客体验与接待效率。
大屏问数
用户以自然语言提问数据,虚拟人快速解析并可视化呈现,秒级响应大屏数据查询需求。
调度指挥
语音指令驱动虚拟人智能调度,实时切换大屏画面、调控系统,辅助指挥决策更高效。
展厅导览
参观者语音互动,虚拟人驱动大屏动态展品牌故事、产品亮点,智能导览更鲜活。
