音频驱动数字人接口避坑指南:从音频预处理到精准口型输出全实操
发布时间:2026/9/6 22:24:54
音频驱动数字人接口的核心价值,是跳过传统TTS语音重生成环节,直接用用户自备的原始口播音频驱动虚拟人动作,从根源上避免二次合成带来的音色失真、语气走样问题,尤其适配已有大量专业录音素材的内容团队。
实战前需先完成两项前置准备:一是在对应平台控制台开通音频驱动专属权限,完成实名认证与企业资质审核,避免调用时出现无明确提示的403报错;二是提前将音频转码为16kHz采样率、单声道16bit的标准格式,用VAD工具裁切过长静音段,防止长音频后半段口型漂移。
调用时需在请求参数中携带指定权限的access_token,开启唇音同步开关,传入预处理后的音频与选定的数字人形象ID,接口会直接提取音频中的语音特征,映射为对应的唇形、微表情与头部动作,无需额外生成中间音频文件。
实测这套方案的中文唇音同步率可稳定超过98%,齿音、爆破音等细节对齐精准,端到端生成耗时比传统TTS驱动模式缩短40%,非常适合课程录制、品牌口播、批量短视频生产等对音频原声保真度要求高的场景。
多个形态 多种资产 个性定义
智能推荐

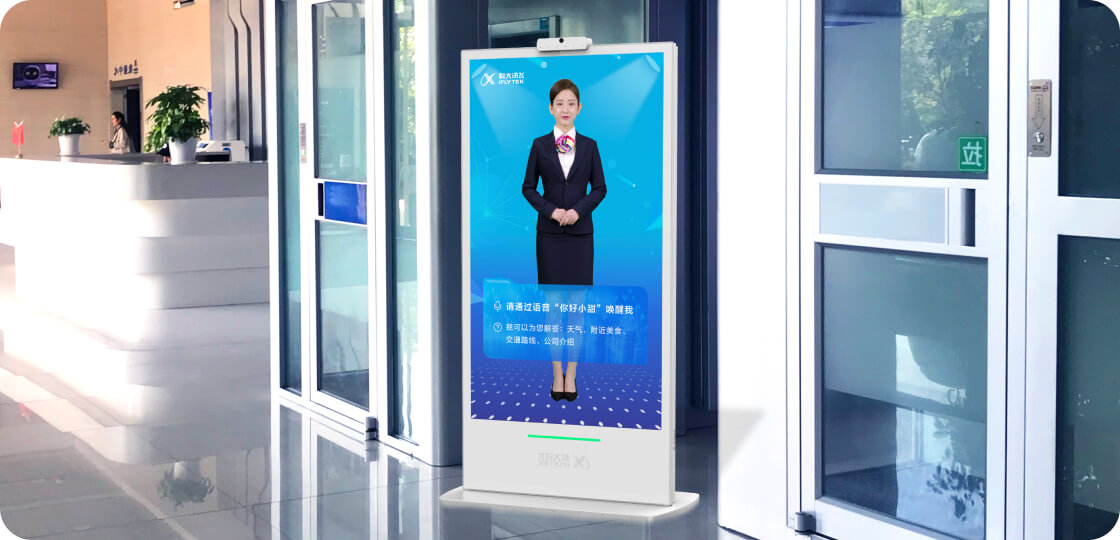
商务接待
虚拟人借自然语言交互,生动讲解大屏数据与业务逻辑,提升访客体验与接待效率。

大屏问数
用户以自然语言提问数据,虚拟人快速解析并可视化呈现,秒级响应大屏数据查询需求。

调度指挥
语音指令驱动虚拟人智能调度,实时切换大屏画面、调控系统,辅助指挥决策更高效。

展厅导览
参观者语音互动,虚拟人驱动大屏动态展品牌故事、产品亮点,智能导览更鲜活。
