告别割裂感:多模态技术让数字人交互从“形似”走向“神似”
发布时间:2026/9/6 22:36:00AI数字人的多模态能力升级,核心是打破口型、表情、语音三者的技术壁垒,实现三者的毫秒级协同统一。传统方案常出现唇音不同步、情绪表达与语音内容割裂的问题,而新一代技术通过端到端多模态生成引擎,将ASR音素切分、面部动作驱动、情感特征识别三大模块深度打通,无需分步手动调参。
在口型同步层面,依托优化后的Wav2Lip 2.0算法,唇动关键帧与语音音节的对齐精度提升至98%以上,双唇音、齿龈音等特殊发音的口型偏差被压缩在2帧以内;情绪响应模块可实时从语音语调、文本语义中提取情感标签,自动匹配对应的微表情与肢体动作,比如讲解易错知识点时自然露出专注神态,答疑时呈现温和亲和的状态;实时交互链路通过全栈本地化部署,将端到端响应延迟控制在300毫秒内,完全消除交互卡顿感。三者协同后,数字人彻底告别机械播报感,在直播教学、智能客服等场景实现类真人的自然交流体验。
多个形态 多种资产 个性定义
智能推荐

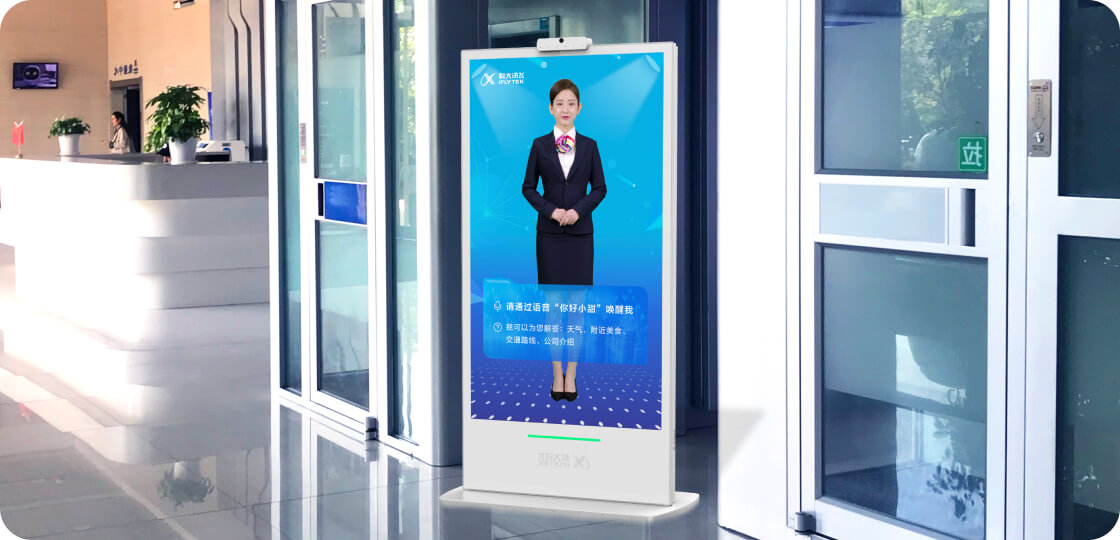
商务接待
虚拟人借自然语言交互,生动讲解大屏数据与业务逻辑,提升访客体验与接待效率。

大屏问数
用户以自然语言提问数据,虚拟人快速解析并可视化呈现,秒级响应大屏数据查询需求。

调度指挥
语音指令驱动虚拟人智能调度,实时切换大屏画面、调控系统,辅助指挥决策更高效。

展厅导览
参观者语音互动,虚拟人驱动大屏动态展品牌故事、产品亮点,智能导览更鲜活。
